
肖鹰用AI聊天截图举报蒋方舟论文造假,这类材料为何不具备学术举报的合法证据效力?一句话回答:因为现行学术不端调查规则明确将AI生成内容排除在可独立采信的证据范围之外,且AI输出自带“幻觉”缺陷,既不满足可核验要求,也无法回溯至原始文本。
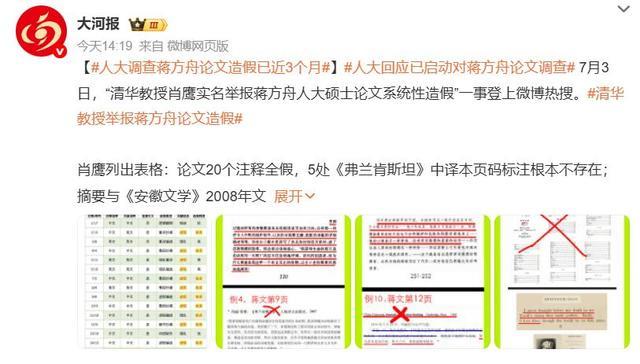
媒体发布的蒋方舟论文造假相关事件报道截图
学术证据的三个硬门槛,AI截图一条都过不了
教育部《高等学校预防与处理学术不端行为办法》及人大、清华等高校的受理细则,对有效证据划出了三个底线:关联性、可核验、原始对应性。
关联性:证据必须直接指向具体的不端行为节点,不能是概括性指控。AI输出的内容基于统计概率,不锚定任何单一原始文本,连“指向哪篇文献、哪一页、哪句话”都无法保证,关联性无从谈起。
可核验:第三方基于同一证据能重复得出相同结论。而同一问题在不同时间、不同模型版本下,大模型的输出结果会出现显著差异。今天ChatGPT说《最后一人》是共和制,明天它可能说是君主制——谁来验证哪个版本是对的?
原始对应性:证据必须可回溯至原始出版物或研究过程留痕。AI聊天截图既不是原本也不是复印件,它没有对应的原始文献锚点,不存在可供第三方核对的出处。
这三条里,AI截图一条都不满足。高校在处置实践中对此已有概括性规则:无原始文献支撑的AI生成内容,仅可作为举报线索供调查方参考,不得直接作为认定学术不端的核心依据。
“AI幻觉”不是bug,是特性——让它永远当不了证据
生成式大模型的核心逻辑,是基于训练语料的统计规律预测下一个词,而不是对原始文本的精准复刻。这意味着它天然会“编造”符合表述逻辑但不符合事实的内容——学术上称为“AI幻觉”。
具体表现包括:
虚构书目和页码:大模型常生成不存在的参考文献、虚构的作者名甚至完全编造的文献条目;
情节概括失准:对文学作品内容的复述与原文设定存在偏差;
规则僵化:基于过时训练数据输出内容,无法匹配最新政策或版本。
这类缺陷不是偶尔报错,而是底层架构的必然产物。正因为此,全球主流学术机构形成了通用准则:AI所有输出内容必须由人类研究者逐一核对原始文本方可使用,包括麻省理工学院在内的高校,均不将AI生成内容作为学术不端裁决的独立依据,仅作为人工评议的辅助参考。
一个对比:为什么肖鹰的其他指控是有效的,但这条不行?
肖鹰在本次举报中同时提供了大量基于逐段逐页文本对照的材料——论文标注的页码在原著中找不到对应内容、20处注释全部虚构等。这些材料满足原始对应性(可回溯到特定出版物)和可核验性(任何人都能拿过原书来验),属于常规采信的有效证据类型。
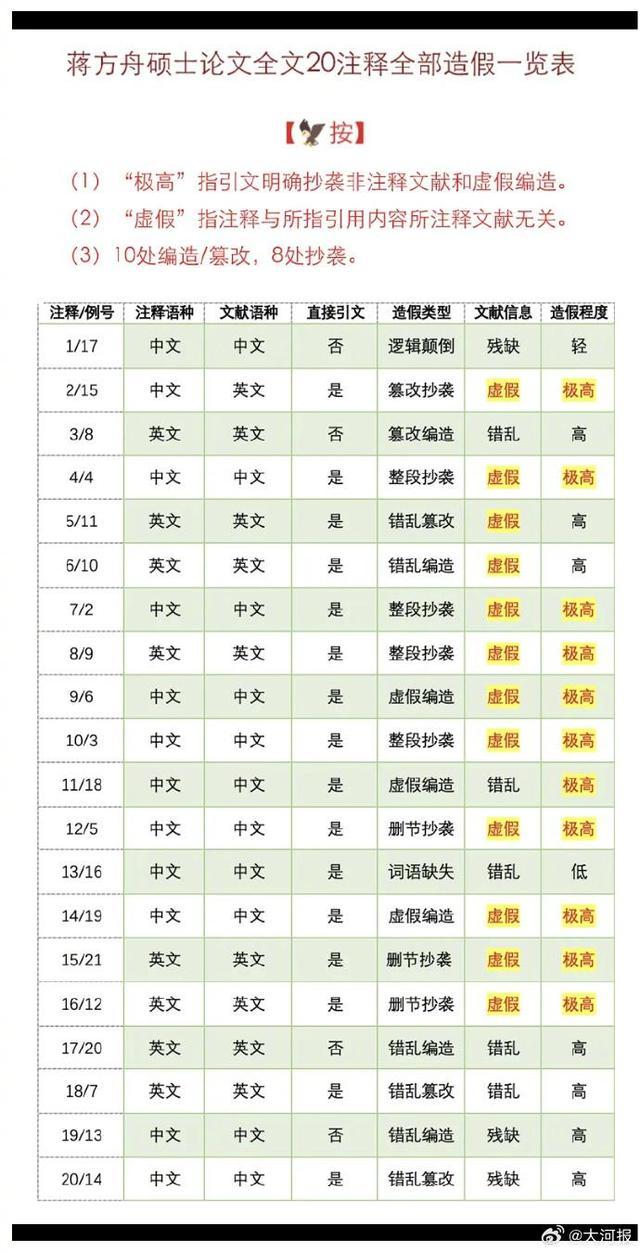
蒋方舟硕士论文20处注释造假情况统计表格
但ChatGPT截图完全不是同一性质。它不是“我读过了原著,这里和原著不一样”,而是“我让AI复述原著,AI说了什么,我就拿它来当标准答案”。这就相当于让一个擅长编故事的杂技师去当历史证人——他说的话再流畅,也不能因为流畅就判定它为真。
你可能想问:那AI截图一点用都没有吗?
有,但它只能是线索,不能是证据。调查方可以把截图作为一个信号——提示他们“这里可能有问题”——然后让调查人员去调取原始出版物做人工核验。但拿着截图直接去定论,就像拿着菜谱说人家没做对菜——菜谱本身可能就把步骤写错了。
把AI生成内容充作证据,本质是把辅助工具的输出结果当成了事实基准。这违背了学术证据最基本的逻辑:你要指控一个人的论文造假,证据必须来自于被指控者的原文或与之对照的原始出版物,不能来自于一个连自己上一句说了什么都无法保证的聊天机器人。
久融配资提示:文章来自网络,不代表本站观点。